1688 买家 Personal Agent 算法负责人 · 1688 AI 实验室
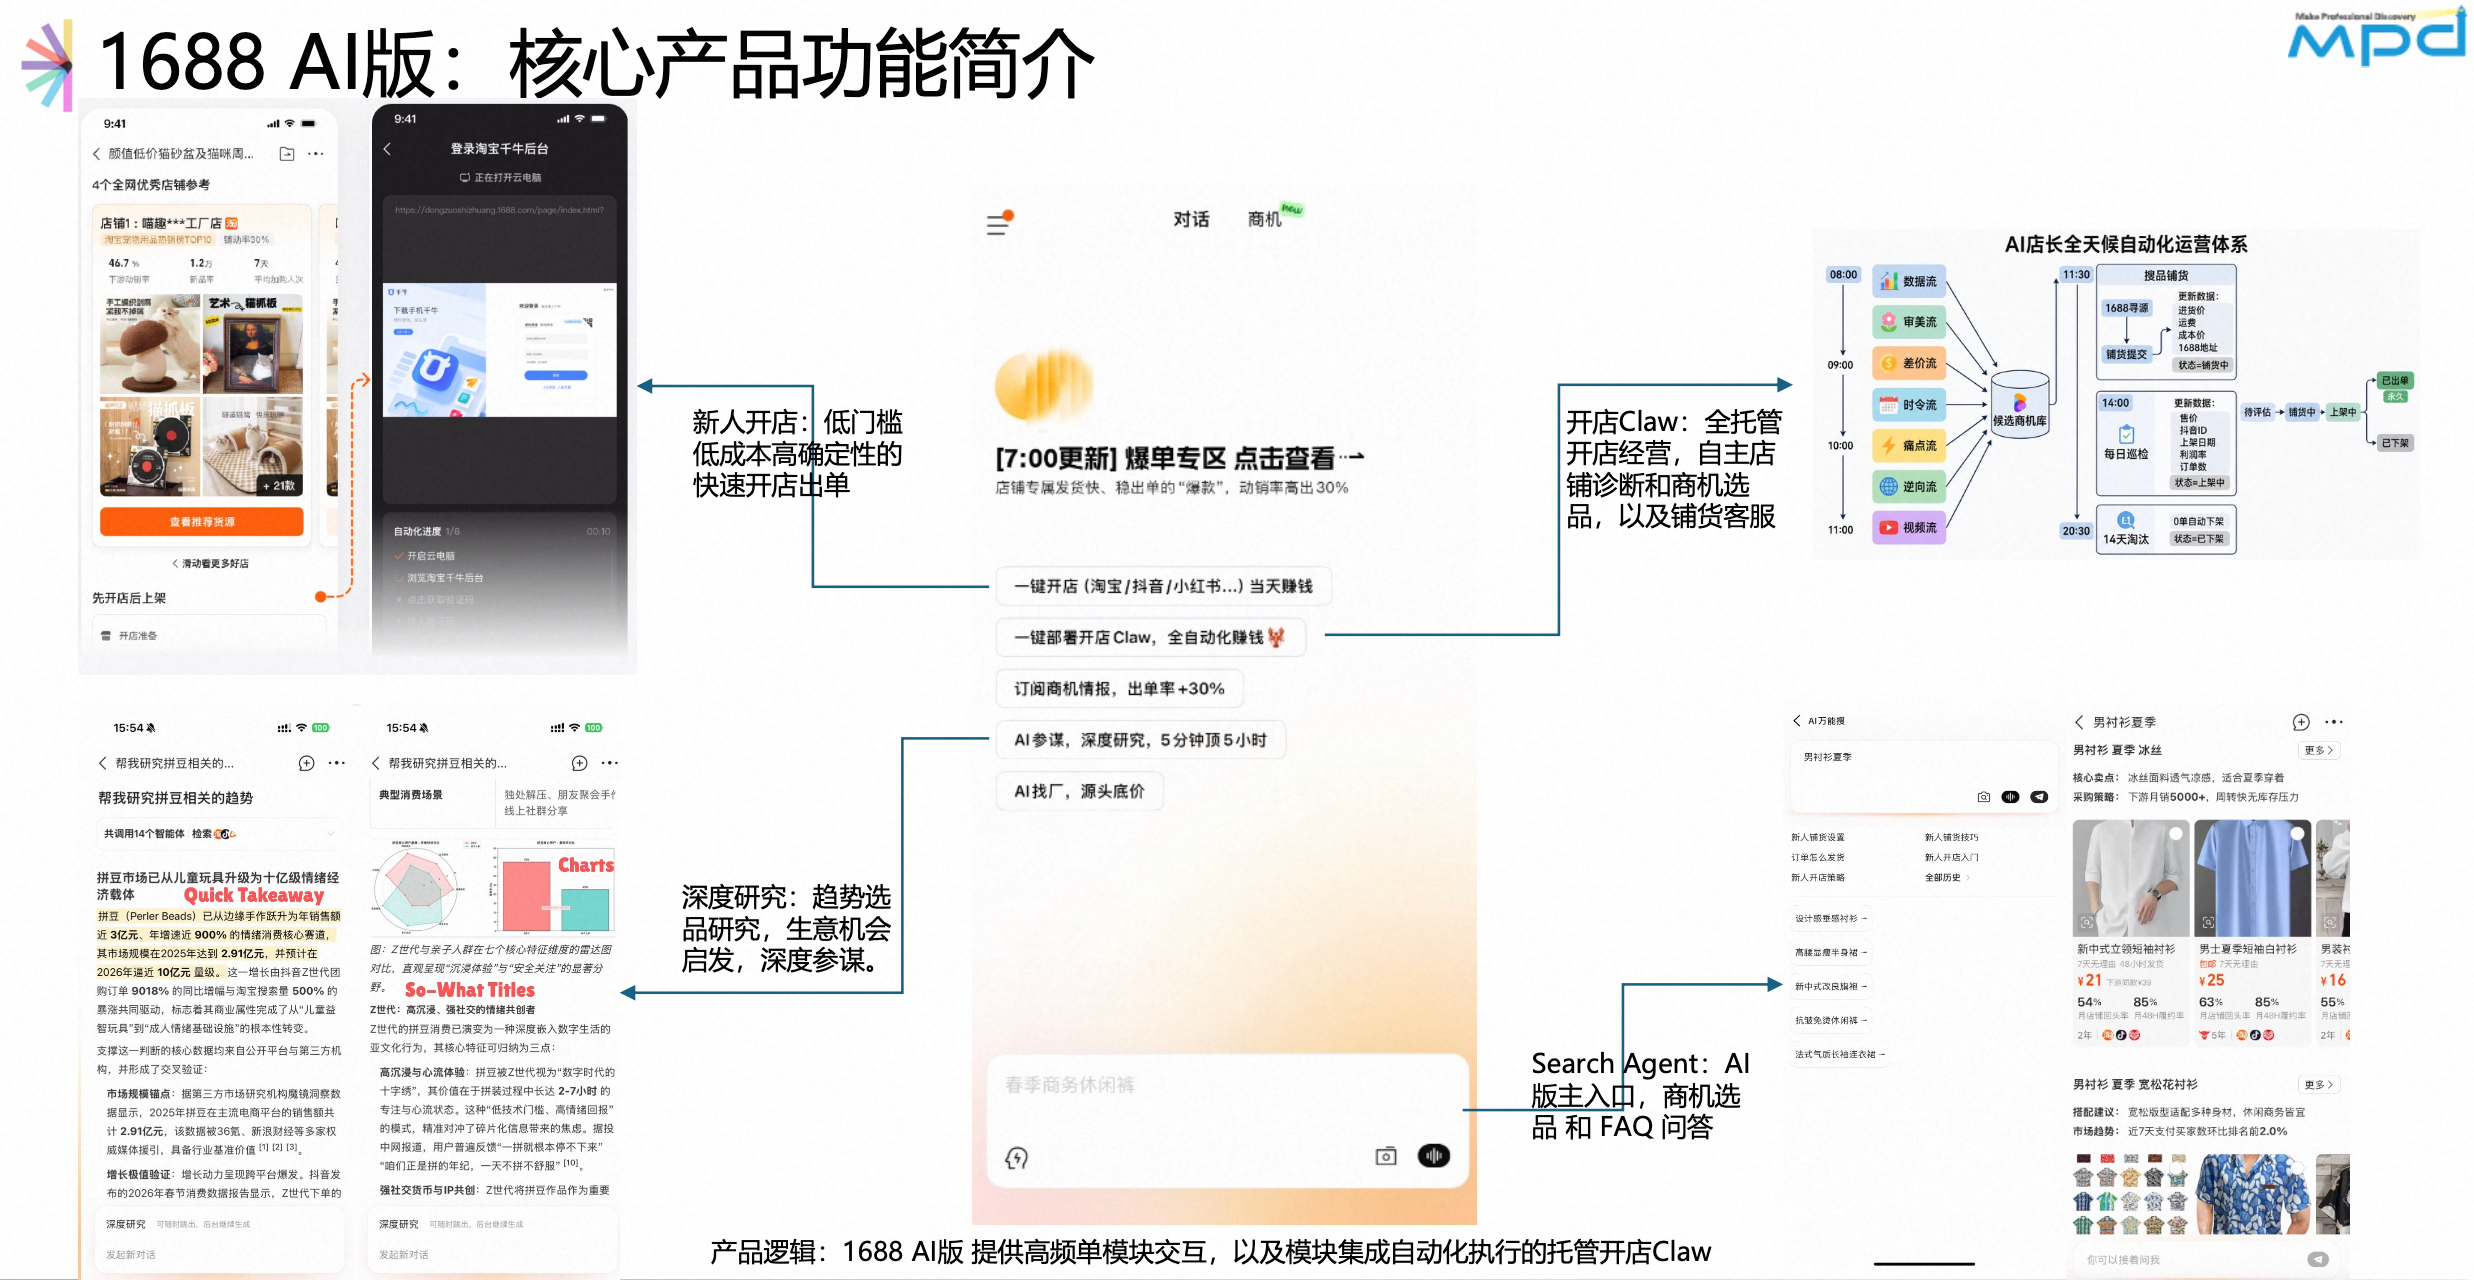
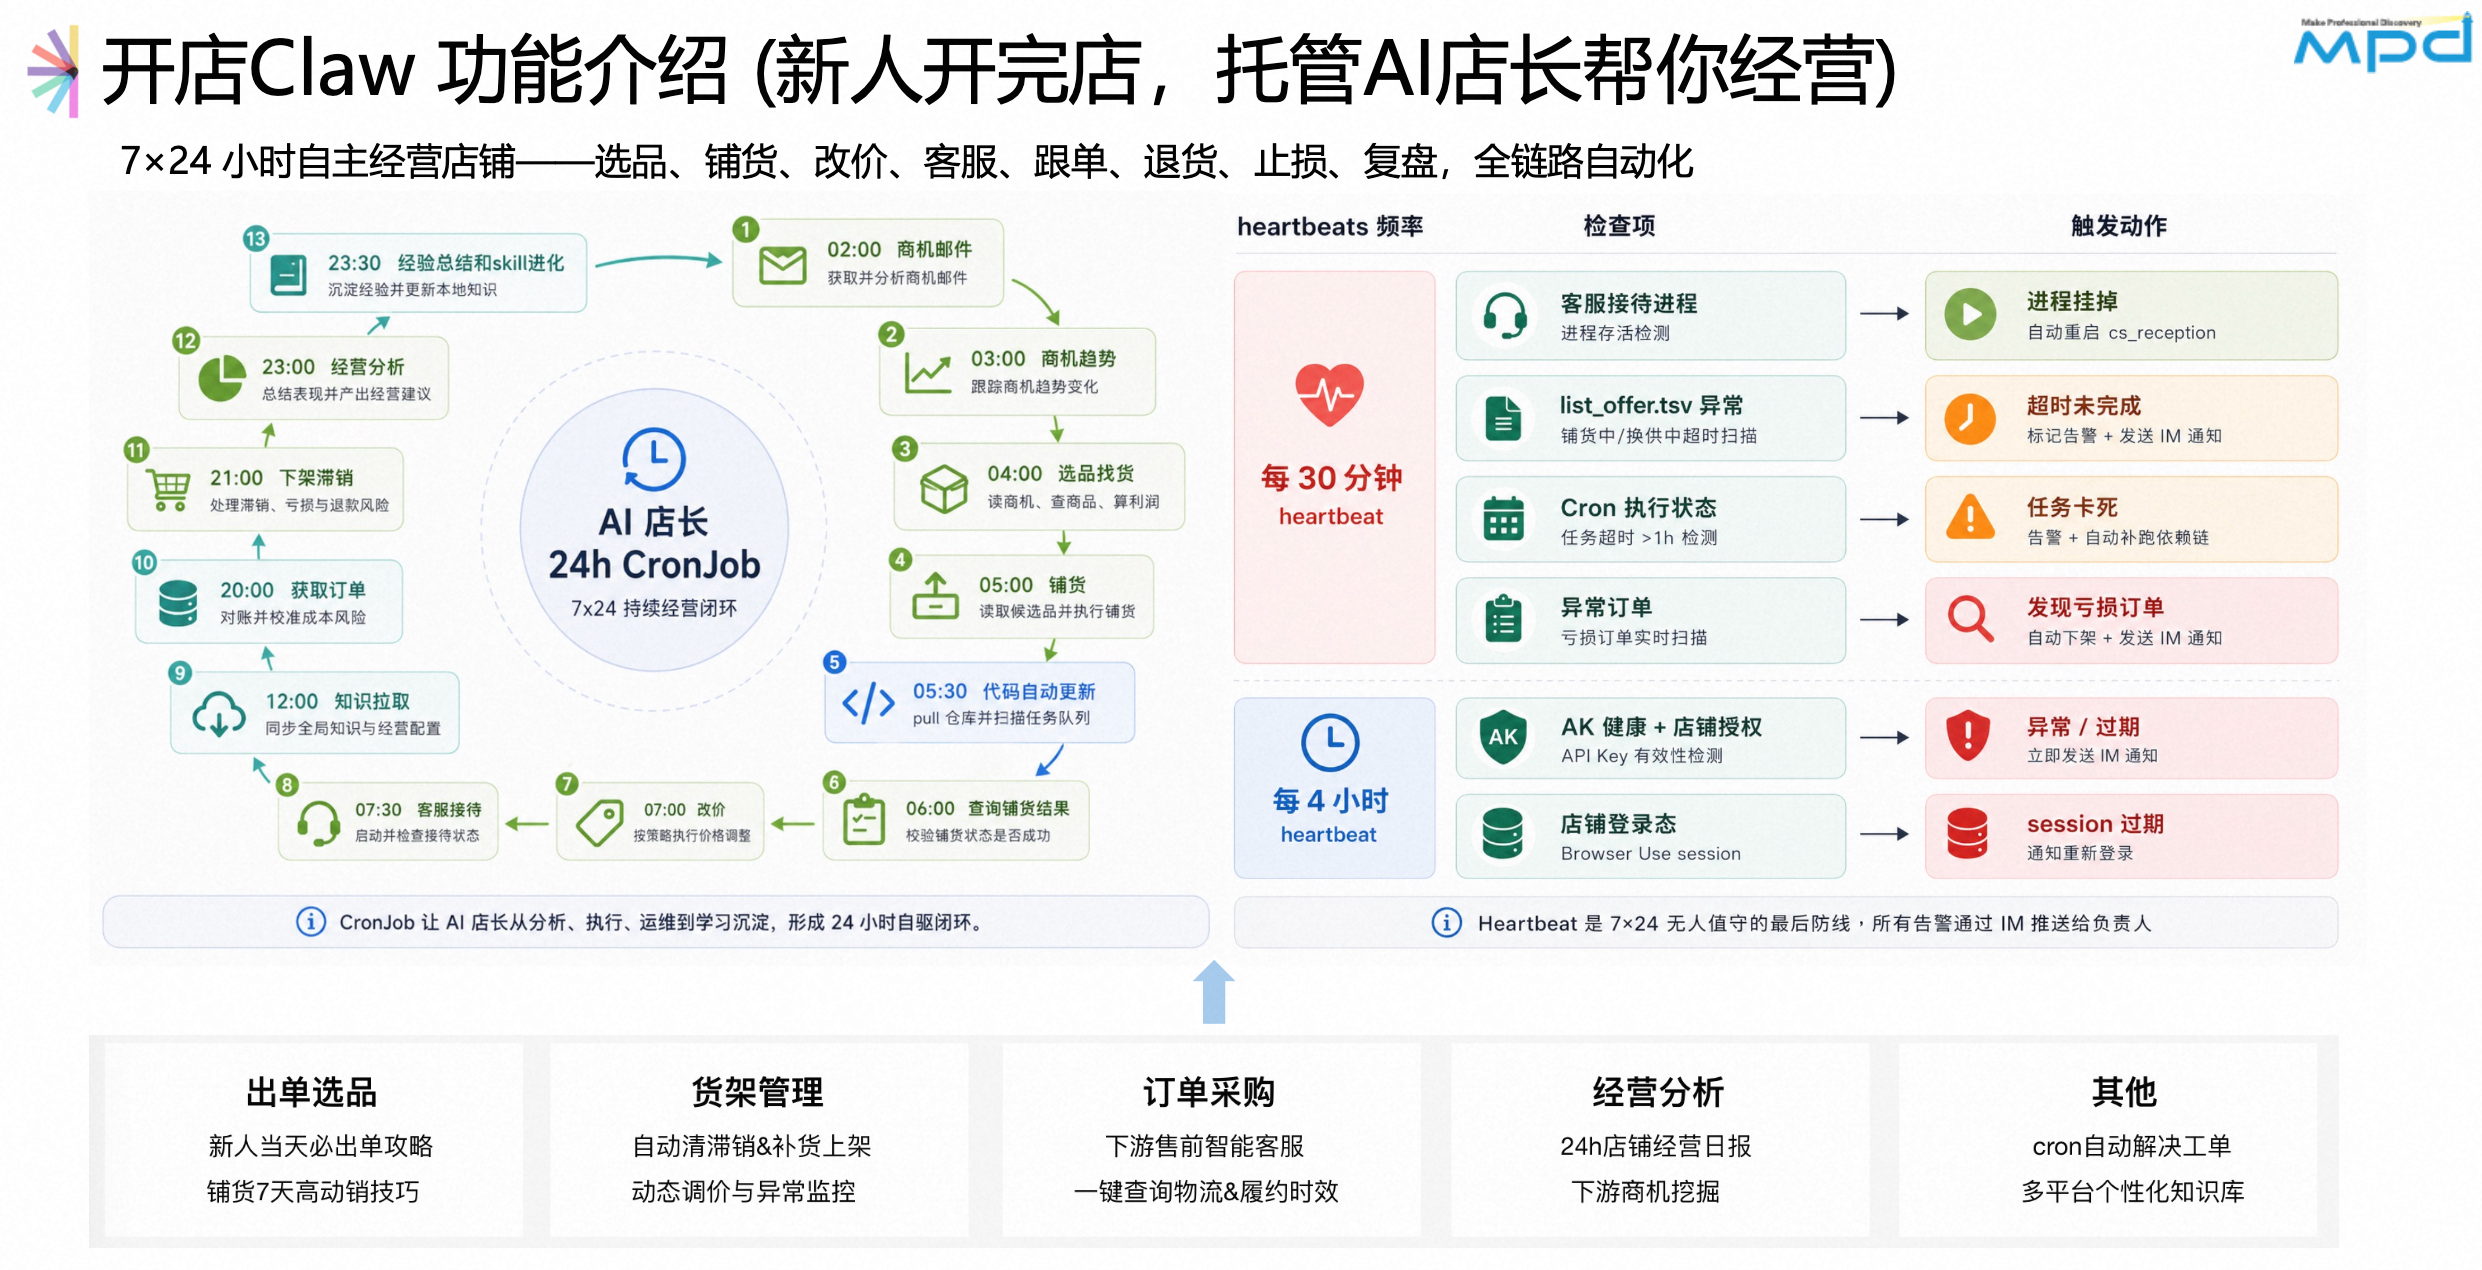
面向买家“从找货采购到开店经营”的需求,带队推进 1688 AI版与买家 Personal Agent 的算法研发。围绕选品、铺货、改价与复盘等连续任务,基于 OpenClaw 构建长程执行、持久记忆与技能学习能力,并通过采购和经营仿真评测迭代 Harness 与 Skill,让助手从单次问答走向持续经营。
[1688 AI版] [1688-ShopKeeper] [MPD 分享]
AI Researcher & Builder
Live in the future and build what’s missing.
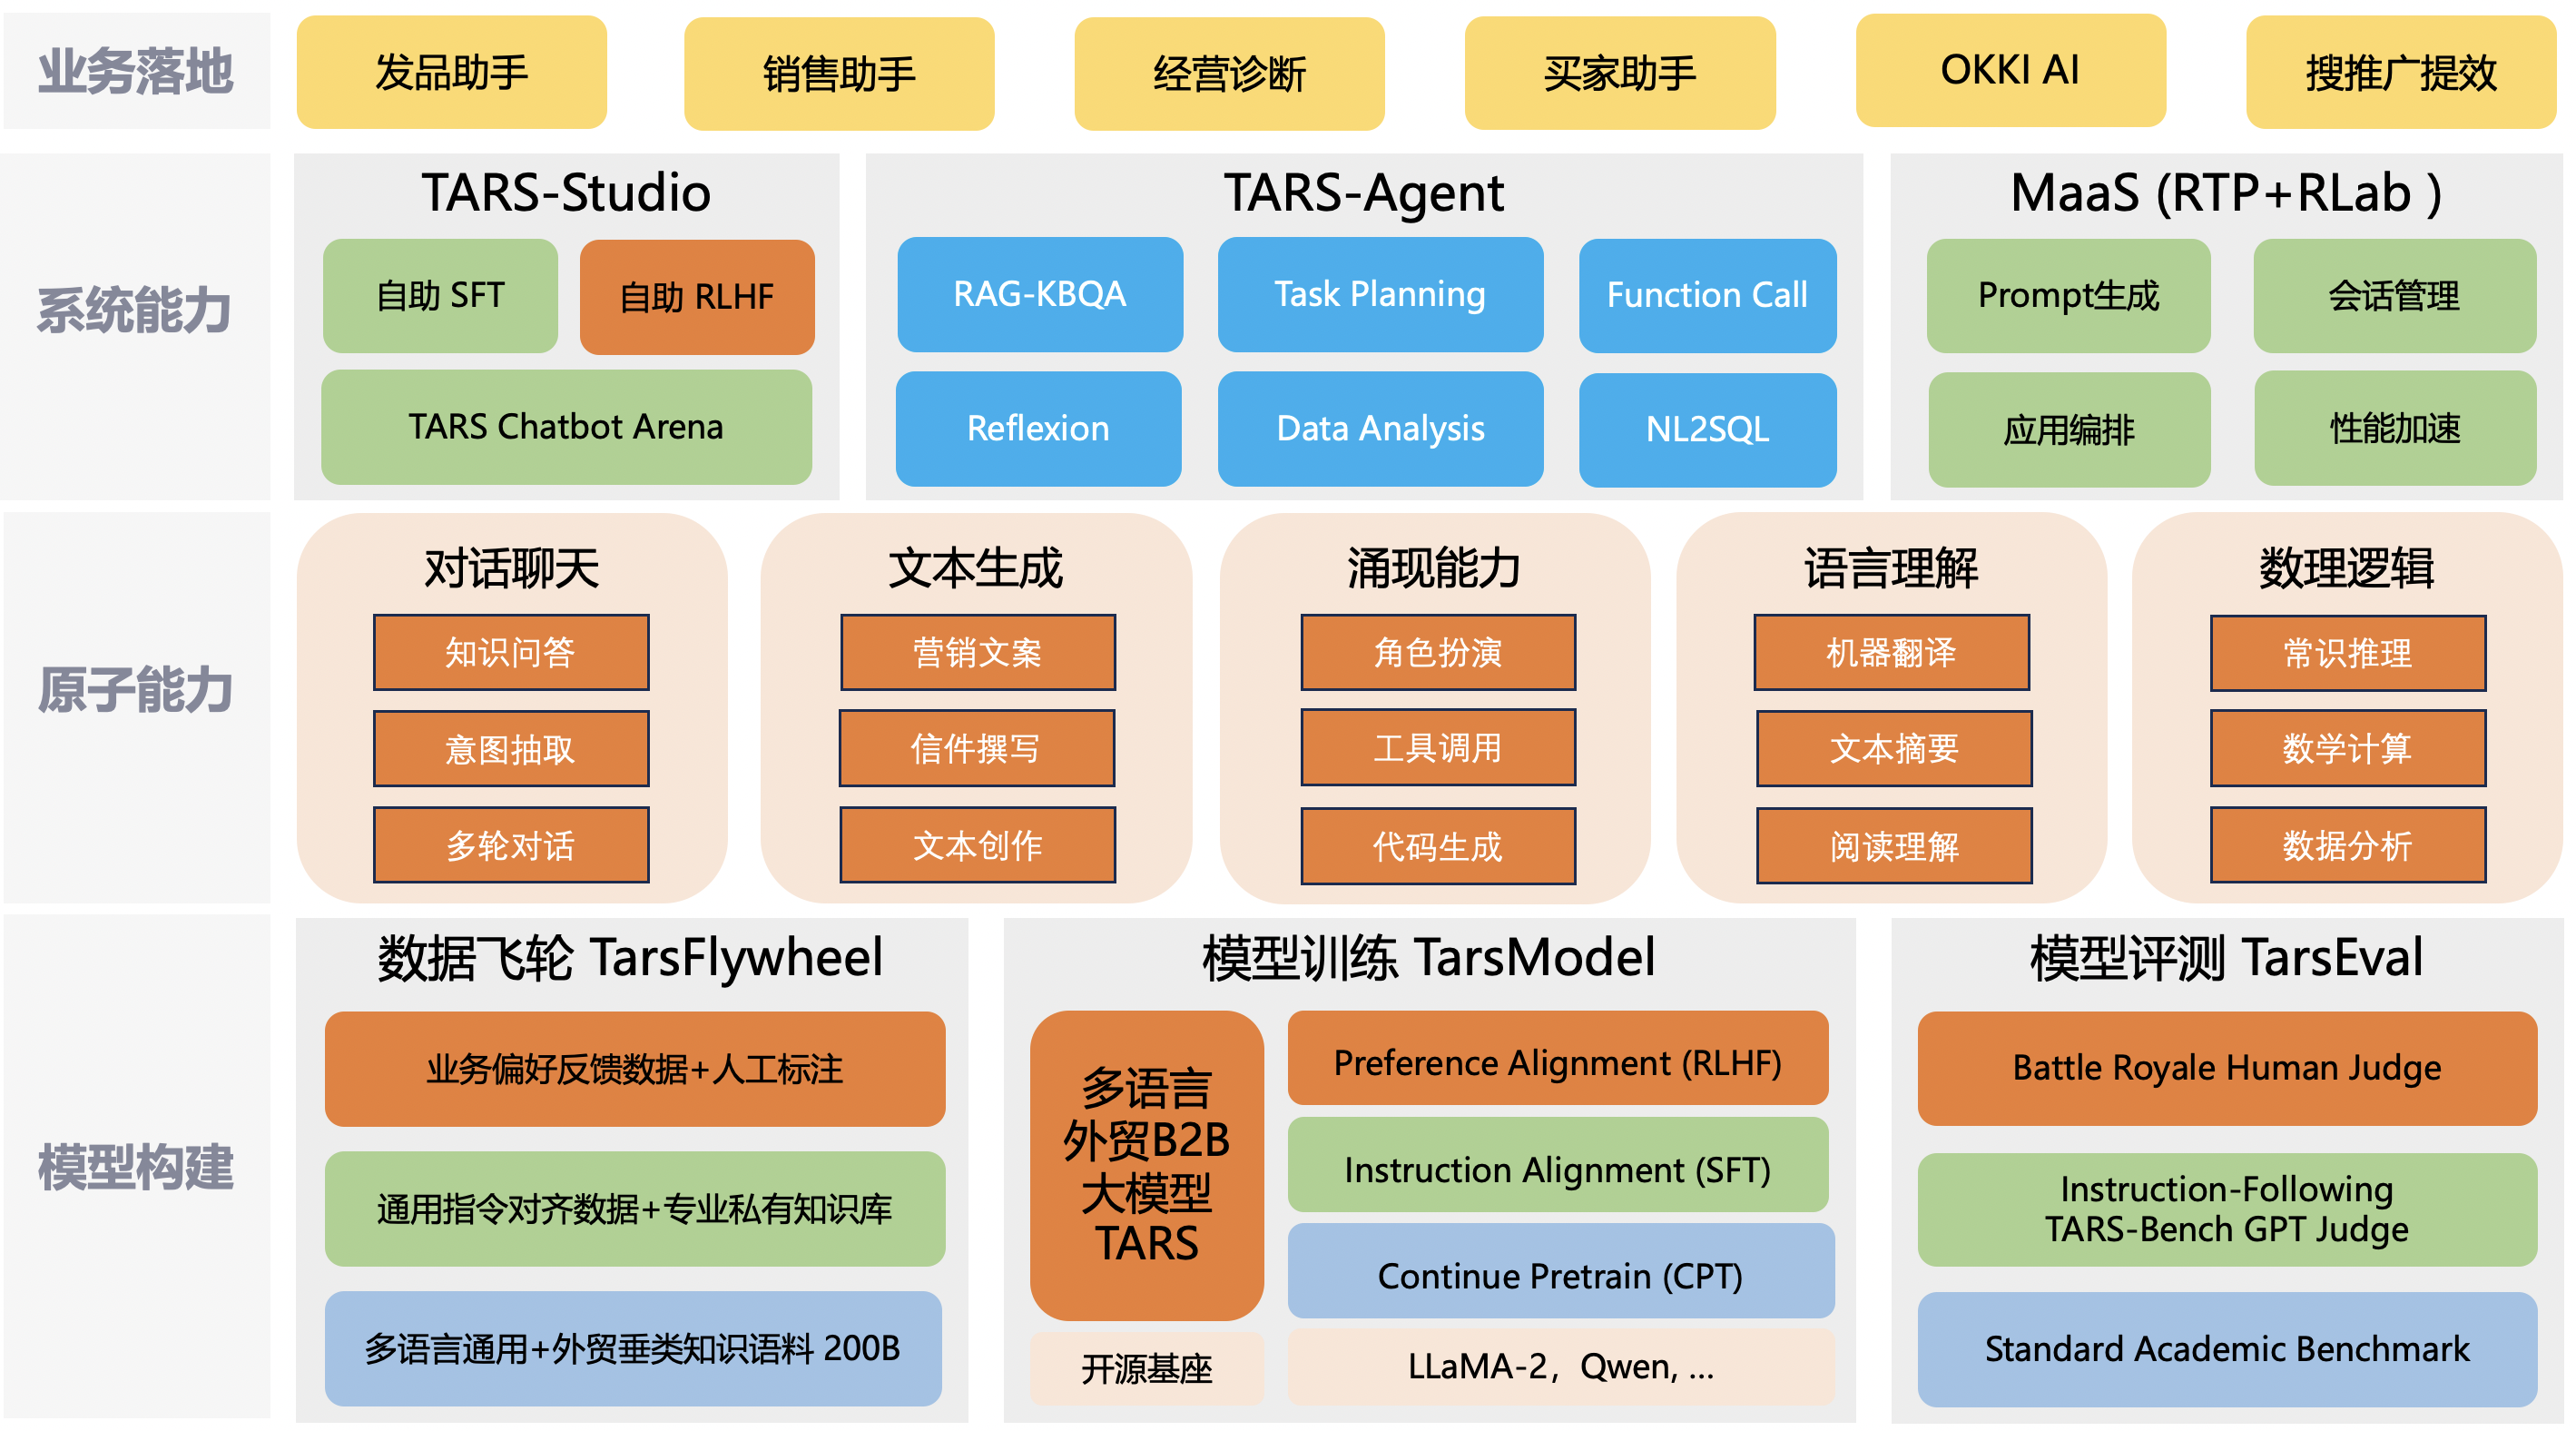
现任1688 AI 实验室算法负责人,带队推进事业部 Agentic AI 技术变革,研究和构建 1688 买家 Personal Agent。此前,在 Alibaba.com 主导跨境电商采购助手 Accio 从 0 到 1 的算法研发,以及统一基座大模型 TARS-LLM 从训练、评测到部署的全链路建设,推动大模型与 Agent 在全球 B2B 采购和经营场景落地。
硕士毕业于新加坡南洋理工大学。从阿里小蜜对话机器人、阿里国际化多语言多模态搜索,到大模型与 Personal Agent,我持续探索如何将前沿技术变成真实可用的产品。带队取得过 OpenLLM 第一名、SuperGLUE 第二名、DeepResearch Bench 全球 Top 3 等阶段成绩,在 WWW、CVPR、SIGIR 等会议发表多篇论文。
我坚信 AGI 的长期潜力,保持对前沿技术的热情,亲手构建,希望用 AI 做有实际价值、有使命感的事。
我关注如何让 AI 理解复杂需求、在真实环境中行动,并从反馈中持续学习。近期重点探索 Personal Agent 与自我改进系统,结合大模型、搜索与多模态技术,构建能长期协作、主动服务的通用助手。
面向买家“从找货采购到开店经营”的需求,带队推进 1688 AI版与买家 Personal Agent 的算法研发。围绕选品、铺货、改价与复盘等连续任务,基于 OpenClaw 构建长程执行、持久记忆与技能学习能力,并通过采购和经营仿真评测迭代 Harness 与 Skill,让助手从单次问答走向持续经营。
[1688 AI版] [1688-ShopKeeper] [MPD 分享]
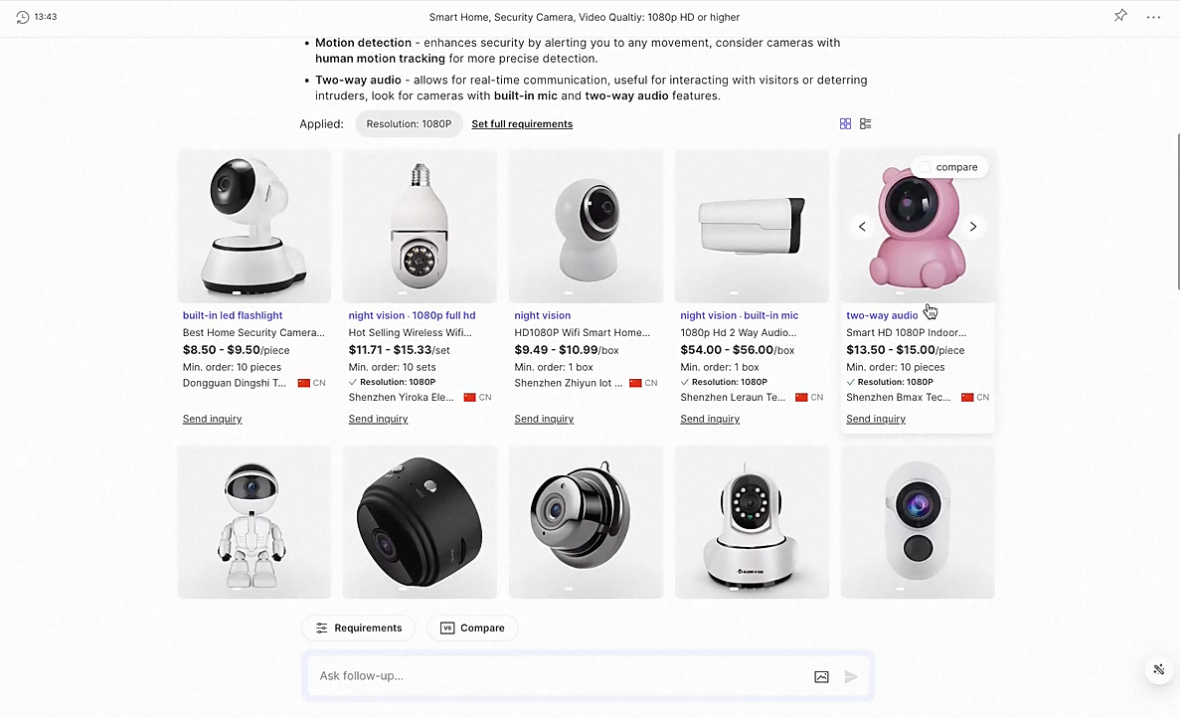
主导 Accio 从 0 到 1 的算法研发,帮助全球买家将模糊采购意图转化为可比较的商品与供应商方案。结合 Agentic DeepSearch、长上下文多模态检索与 Multi-Agent 协作,完成需求澄清、分步寻源与信息交叉验证;通过对话与可视化结果联动,让用户在多轮交互中逐步收敛采购决策。
主导 Alibaba.com 统一大模型底座的全链路建设,构建 TARS-Train 训练、TARS-Eval 评测与 TARS-Studio 服务平台。通过指令数据构造、多任务训练与 Multi-LoRA Adapter 融合,提升外贸知识、多语言交互和工具调用能力;以共享基座、多 Adapter 的服务方式支撑业务规模化落地,应用于生意助手的内容生成、客户接待与商业分析。
[OpenLLM 榜单 Top1] [生意助手]
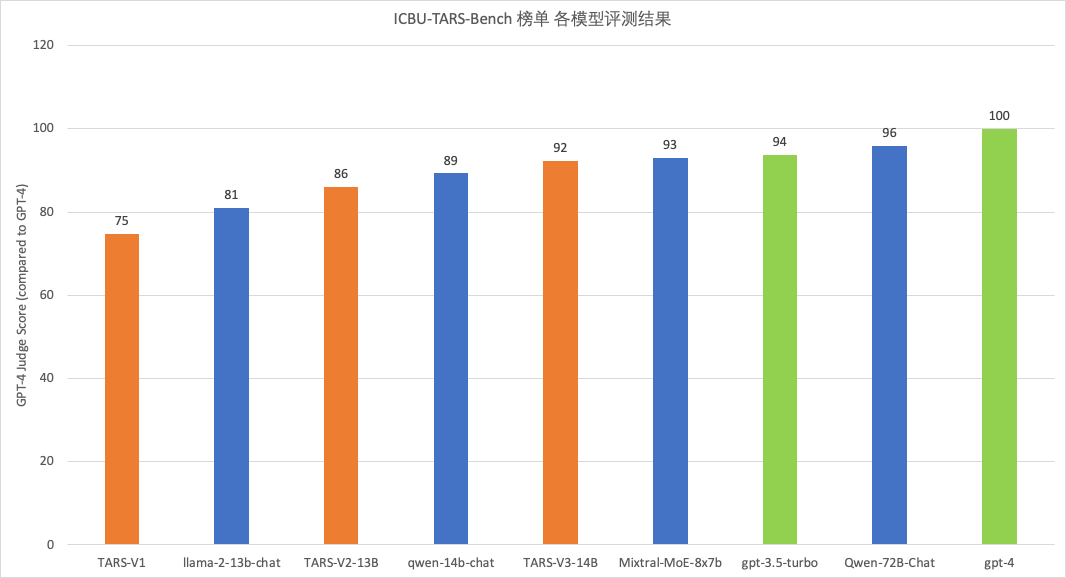
项目历史资料:右图为 ICBU-TARS-Bench 的 GPT-4 Judge 相对评分(GPT-4 = 100),用于展示当时版本的迭代,非当前模型榜单。
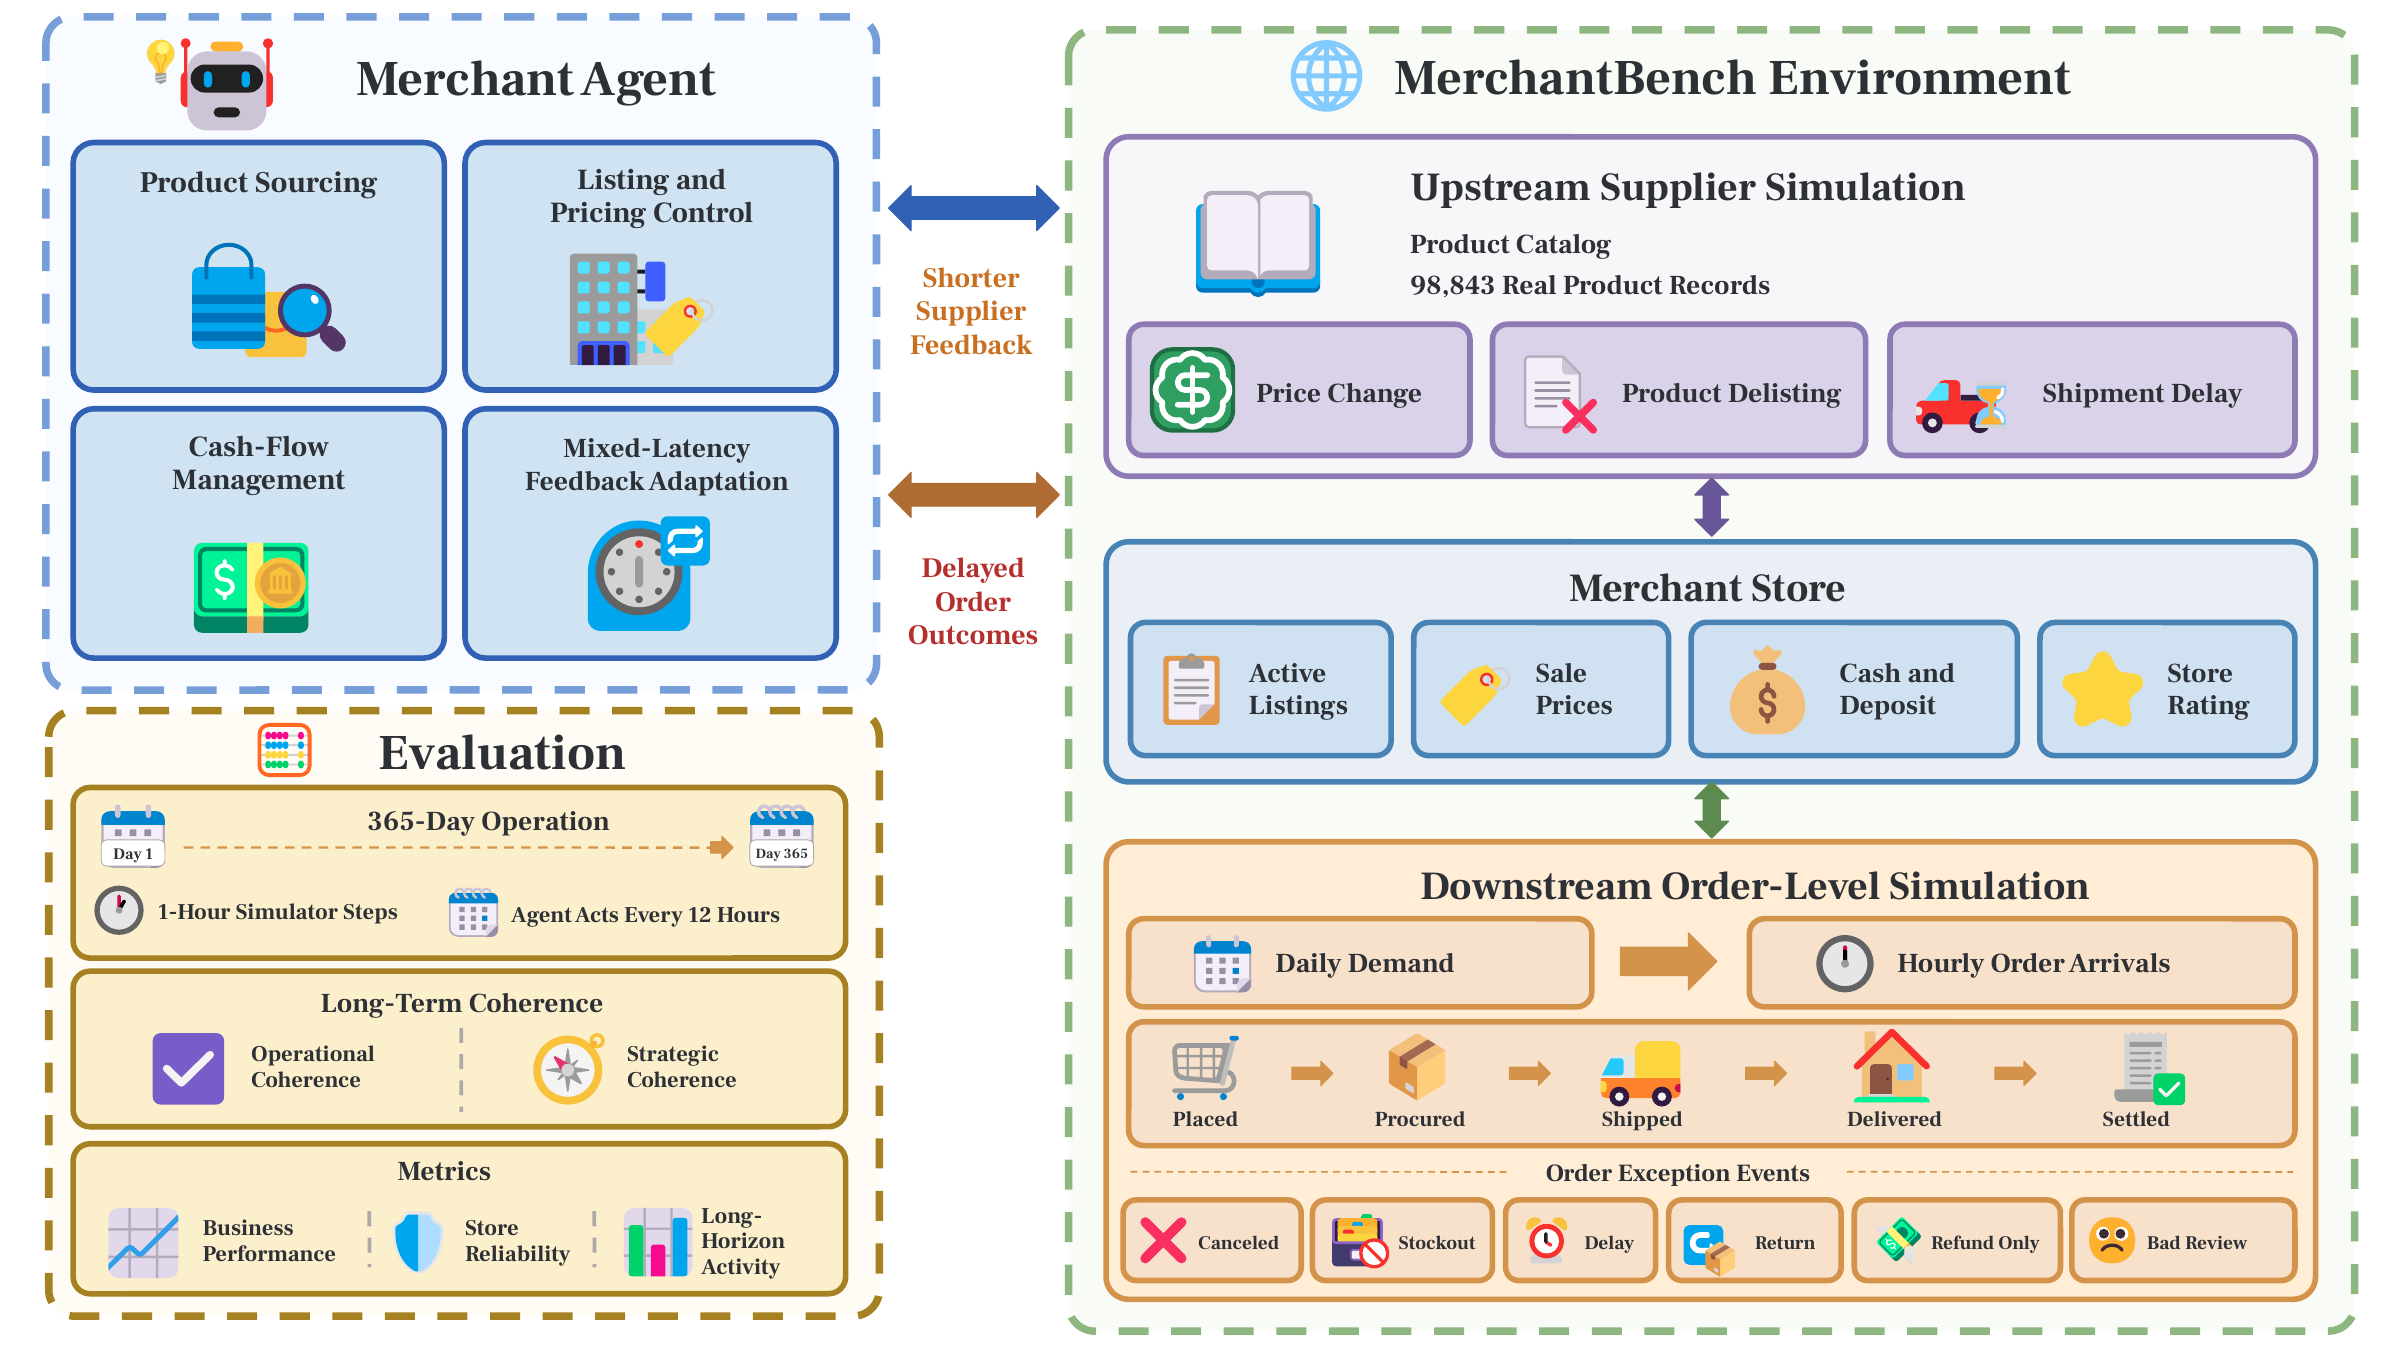
这篇论文关注 Agent 能否在长期经营中持续做出一致、有效的决策。我们提出 MerchantBench,将采购、定价、现金流约束和延迟反馈纳入统一的电商经营环境,检验 Agent 能否追踪订单、应对供需变化并调整策略。
基于 98,843 条真实商品记录构建 365 天订单级仿真,提供 26 种交互工具。在 8 个大模型、两种 Agent 框架的 48 次运行中,最佳模型配置的期末净资产仅为人类参与者平均值的 27.3%,揭示当前 Agent 与人类在长期经营决策上的显著差距。
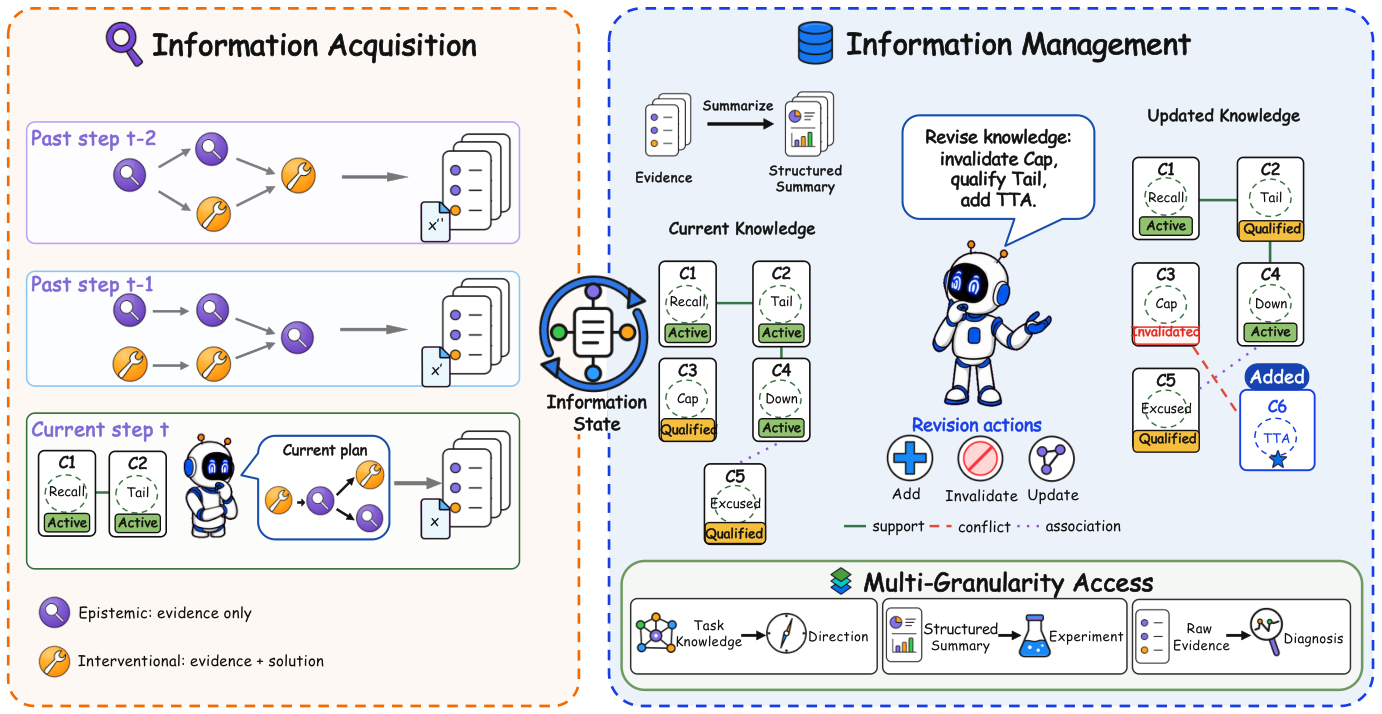
我们提出 Iris,让 AI 主动识别机器学习实验中的未知问题、规划实验,并根据新证据修正已有认识。框架结合自适应实验规划、主动诊断与知识修订,将实验观察沉淀为可更新的任务知识,指导下一步决策。
在 MLE-Bench 全部 75 项任务上,以单任务 12 小时预算取得 64.9% 获牌率、39.1% 金牌率,达到论文对比系统中的 SOTA(2026)。同为 Claude Opus 4.6 基座,金牌率高于 AIBuildAI 的 25.8%,时间预算仅为其一半。
[论文]
我们提出面向企业场景的 SQLord,解决 Text-to-SQL 中领域数据不足与业务逻辑复杂的问题。通过从已有 SQL 反向生成训练数据、将复杂查询拆解为可执行工作流,结合业务知识与表结构检索完成多步分析,并用 GPT-Judge 评估查询与 SQL 的一致性。
企业数据集执行准确率达 86.5%,超过 DAIL-SQL(GPT)13.6 个百分点;在论文的 Spider 对比实验中达到 87.4%,优于所比较的方法。已应用于生意助手-智能选品能力。
[论文]
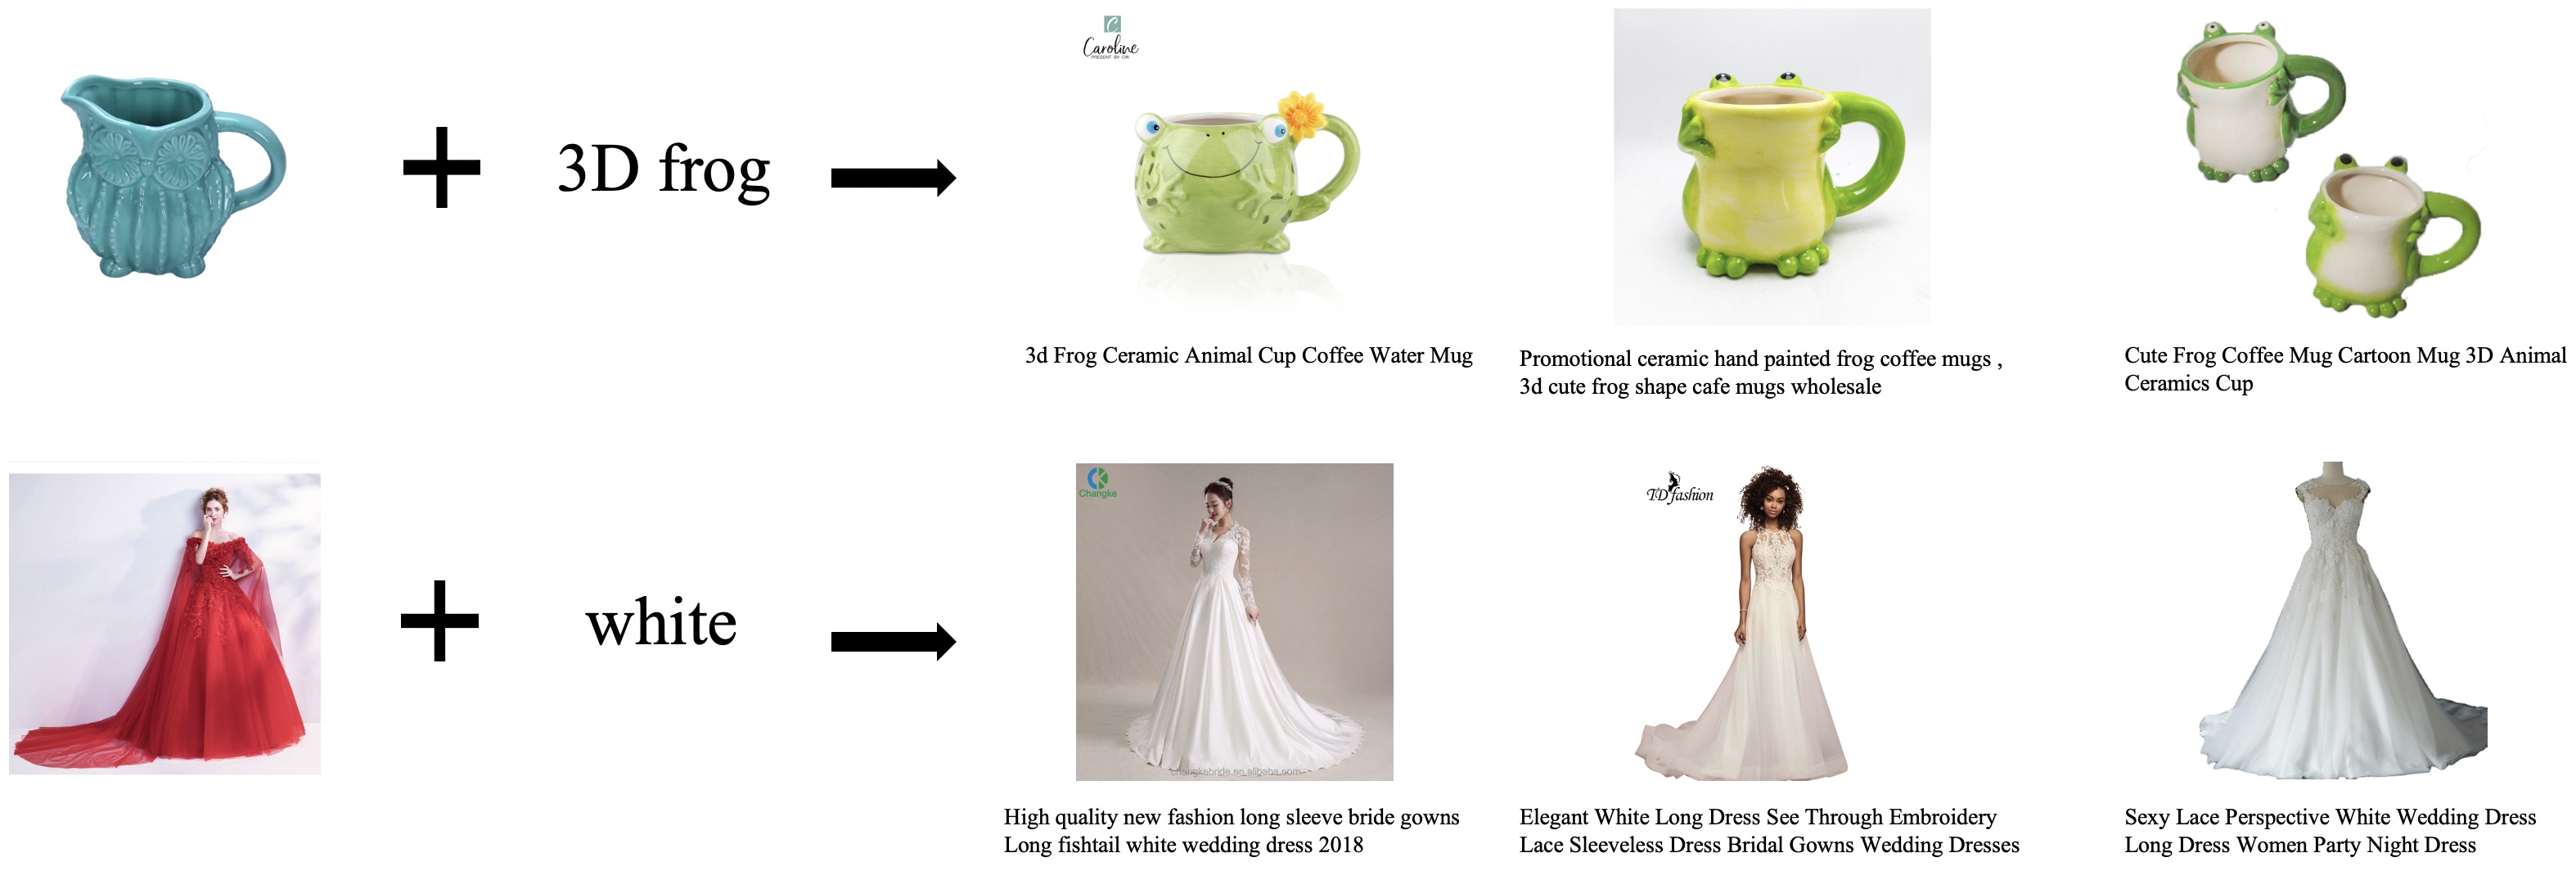
这篇论文研究电商同款检索中的图文融合。我们将图像、文本及图文组合映射到统一表示空间,从点击日志中构建训练样本,让检索同时利用商品外观与文字属性。该方法支持“图片 + 修改要求”的交互式搜索,并已应用于 Alibaba.com 相似商品检索。
线上 A/B 测试:同款商品覆盖率 +64.9%、点击率 +2.51%、转化率 +2.31%(相对提升)。图文联合检索 Recall@1 达 88.70%(5,196 对人工标注样本)。
[论文]
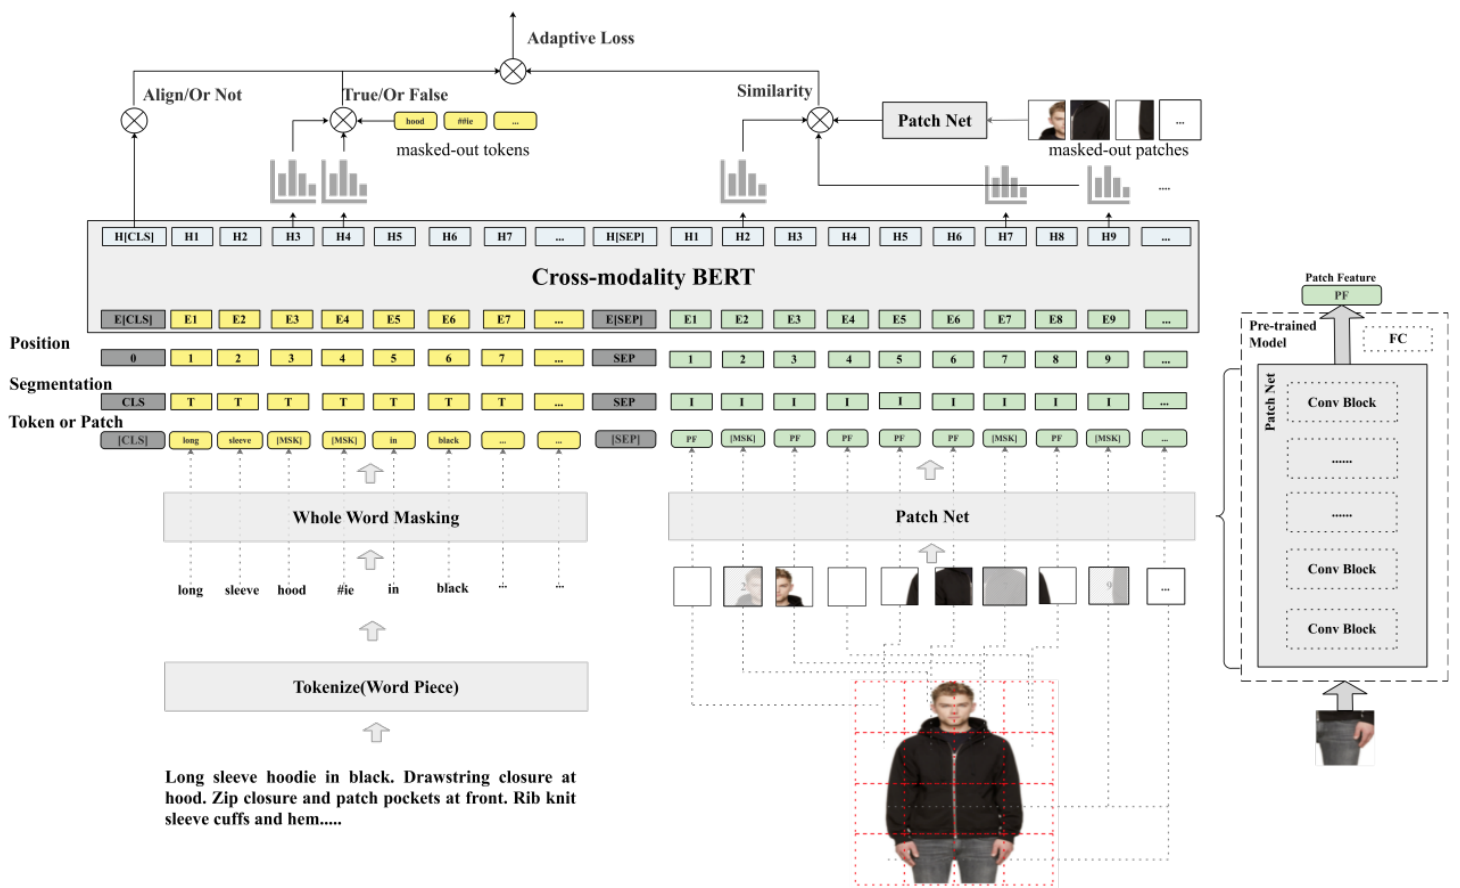
我们提出 FashionBERT,是较早采用图像 Patch 与文本 Token 联合建模的视觉语言预训练工作之一。通过将图像局部特征与文本共同输入 Transformer,并以自适应损失平衡多项预训练任务,模型能够捕捉纹理、款式等细粒度信息。
在 Fashion-Gen 图文匹配与双向检索评测中达到当时 SOTA,以文搜图、以图搜文的 Rank@1 分别超过最强对比方法 4.12、2.99 个百分点。
组建 AI 实验室算法团队,推进 1688 AI版 的算法研发与产品落地,探索买家长程经营 Personal Agent 与仿真评测。
负责多语言多模态搜索,从需求理解、召回到相关性匹配,推动完成从关键字检索到 xBert 语义搜索的技术变革。